La música de las películas deHarry Pottersirvió para poner a prueba una pregunta cotidiana: cómo hace el cerebropara separar una voz de la música que suena detrás. Un grupo de investigadores de Canadá y Francia concluyó que el cerebro puede distinguir el habla de la música a partir de patrones simples del sonido, incluso cuando ambas ocurren al mismo tiempo.
El estudio fue publicado en la revista Science Advances. Para el experimento, los científicos usaron casi ocho minutos de la pista de audio en francés de Harry Potter y la piedra filosofal.
La elección no tuvo que ver con la historia del joven mago, sino con las características de una película: diálogos, música y ruidos se alternan y se mezclan como sucede en la vida real.



Una escena de cine permitió estudiar una escucha cotidiana
En una conversación en un restaurante, durante una serie o al viajar en transporte público, las personas suelen oír muchas cosas a la vez. Sin embargo, pueden identificar con rapidez si predomina una voz, una canción o las dos. Los autores buscaron saber si esa diferencia ya está presente en la manera en que el cerebro registra las cualidades básicas de cada sonido.
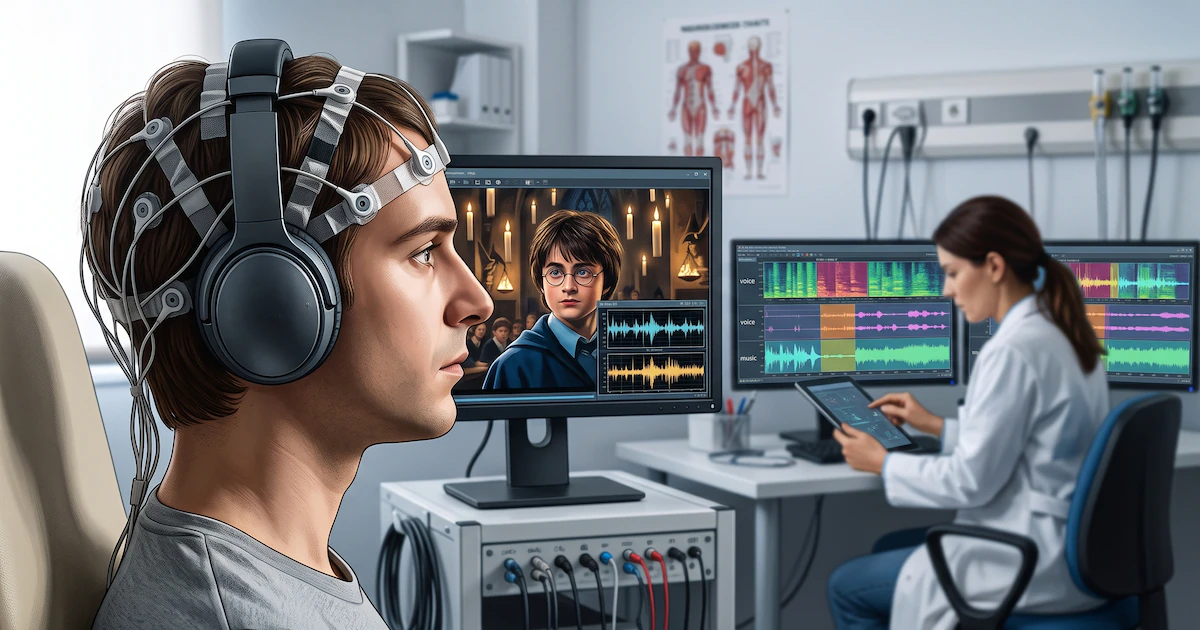
Para hacerlo, reunieron dos grupos. Once pacientes con epilepsia,que ya tenían electrodos colocados por razones médicas, escucharon el fragmento de la película mientras los investigadores registraban la actividad de zonas auditivas de su cerebro.
Por separado, 19 adultos sanos oyeron la misma grabación y debían indicar, con dos teclas, cuándo escuchaban habla, música o ambas a la vez.
El resultado fue consistente entre los participantes. Las respuestas coincidieron en gran medida sobre los momentos en que había voces y sobre aquellos en que sonaba música. Esa información permitió comparar lo que las personas decían escuchar con los patrones del audio y con las señales cerebrales registradas.
Las voces cambian rápido y la música ocupa más frecuencias
El equipo analizó dos rasgos sencillos del sonido. Uno fue la velocidad con la que varía a lo largo del tiempo. El otro, cómo se reparte entre sonidos graves y agudos.
Aunque estos nombres pueden sonar técnicos, se refieren a algo familiar: las sílabas de una voz cambian con rapidez, mientras que una melodía suele conservar y combinar notas durante más tiempo.
Los modelos informáticos identificaron cambios rápidos en el tiempo como la principal señal del habla. En cambio, para reconocer la música resultaron más importantes las diferencias entre frecuencias, es decir, la combinación de notas y tonos que forman una pieza musical.
Cuando los científicos aplicaron esos datos directamente a la pista de audio, lograron reconocer la presencia de habla con una precisión de entre 97% y 99%. Para la música, la precisión fue de entre 99% y 100%. En otras palabras, los rasgos básicos del sonido bastaron para anticipar lo que los oyentes señalarían como voz o como música.
La prueba también se repitió con otro material: una mezcla controlada de voz y música de órgano. Los resultados fueron parecidos, una señal de que el hallazgo no dependía solo de la banda sonora de Harry Potter.
La actividad cerebral siguió las señales de cada tipo de sonido
Los registros de los pacientes mostraron que varias zonas auditivas de ambos lados del cerebro seguían esos cambios del sonido. Los investigadores hallaron 39 puntos de registro que respondían de manera estable a las características relacionadas con voces y música.
Además, distintas formas de actividad cerebral parecieron intervenir en tareas diferentes. Las señales cerebrales más rápidas se relacionaron sobre todo con las variaciones veloces que ayudan a seguir el habla. Las más lentas se vincularon más con las diferencias entre tonos que ayudan a reconocer la música.
También apareció una diferencia entre hemisferios. El lado izquierdo del cerebro mostró una relación más fuerte con el habla, mientras que el derecho se vinculó más con la música. Esa división coincide con investigaciones anteriores sobre cómo el sistema auditivo procesa el lenguaje y los sonidos musicales.
A partir de las señales registradas, el equipo reconstruyó de forma parcial los patrones del audio. Luego comprobó si esas reconstrucciones podían anticipar los juicios del grupo de voluntarios.
La precisión fue más modesta que al analizar directamente el sonido, pero superó el nivel esperado por azar: entre 54% y 60% para el habla, y entre 54% y 71% para la música.