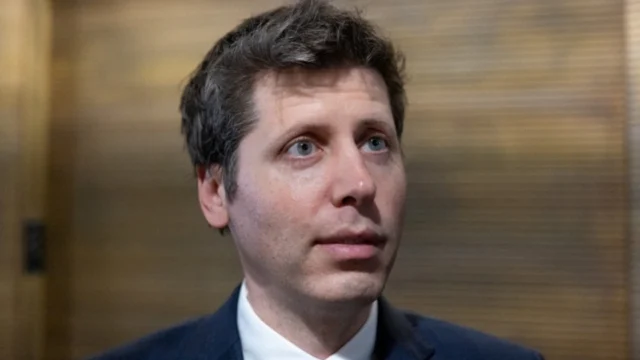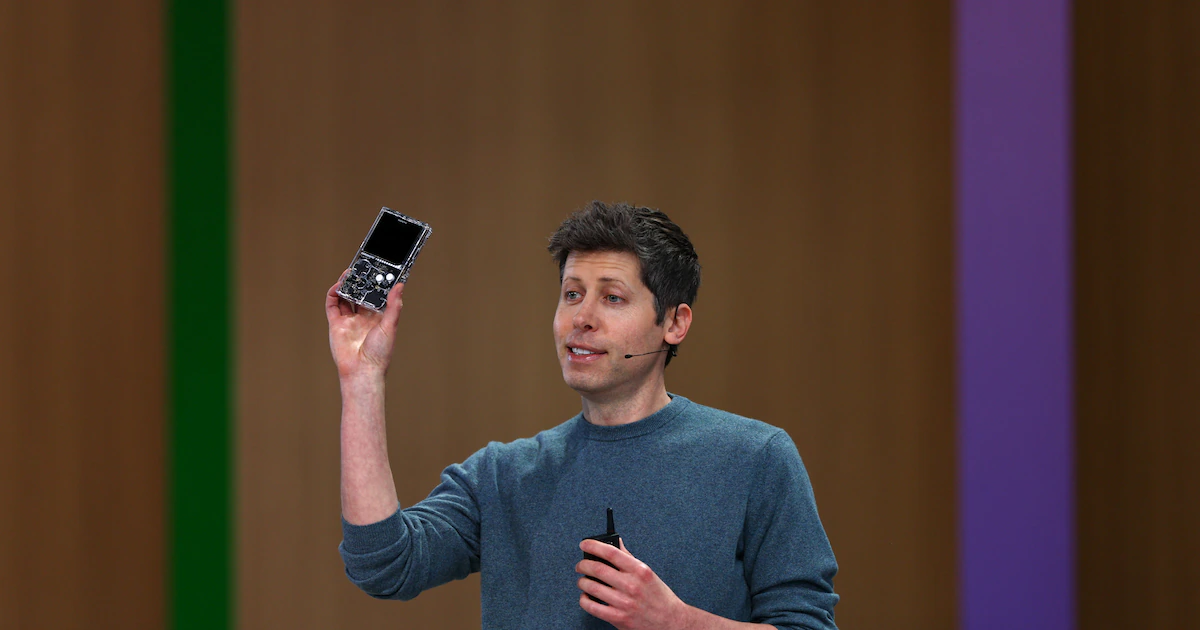
Sam Altman cree que la inferencia local de inteligencia artificial es un error de cálculo a gran escala. Según el cofundador de OpenAI, cada ordenador personal con memoria DRAM instalada la utiliza apenas un 5% del tiempo, un desperdicio que considera inasumible en un momento de escasez crítica de este componente.
La afirmación surgió durante su paso por Cheeky Pint, el pódcast conducido por John Collison, cofundador de Stripe, donde también ha pasado por el micrófono Susan Li, directora financiera de Meta.
El comentario de Altman apunta directamente a una tendencia que ha ganado terreno entre usuarios y desarrolladores: montar modelos de inteligencia artificial de código abierto en el propio hardware, sin depender de servidores externos.



Para el directivo, esa práctica, aunque entendible desde la privacidad del usuario, representa una mala asignación de un recurso que hoy escasea a nivel mundial.
Por qué Sam Altman considera un desperdicio la inferencia local de IA
Durante la conversación con Collison, Altman fue tajante al describir el fenómeno de la IA local como un problema de fondo que la industria tecnológica no está dimensionando correctamente. En sus palabras:
“La inferencia local es una terrible asignación de recursos escasos. Mucha gente quiere inferencia local y, de algún modo, asume que el problema está resuelto porque tenemos modelos de código abierto que podemos ejecutar en nuestros ordenadores y, así, no necesitar todas esas cosas que permiten los centros de datos”.
El argumento central del CEO de OpenAI se apoya en una lógica de eficiencia global. Si una pieza de hardware tan limitada como la DRAM solo se aprovecha una fracción mínima del día en un equipo doméstico, mientras los centros de datos podrían exprimirla las 24 horas, el reparto actual de recursos no tiene sentido desde una perspectiva de optimización.
Así lo planteó el propio Altman: “Pero, desde una perspectiva de asignación global, en realidad es bastante terrible que todo el mundo tenga su propio ordenador con una DRAM que se utiliza apenas el 5% del tiempo cuando estamos en un momento en el que este es un recurso tan limitado”.
La conclusión que extrae de ese diagnóstico es clara: en un contexto de oferta restringida, los recursos deberían concentrarse donde generan mayor rendimiento. “En ese entorno en el que ese suministro crítico es tan restringido, quieres la máxima concentración en la nube. Pero, de algún modo, la idea de la gente es la contraria”, afirmó durante el pódcast.
La inferencia local consiste en ejecutar un modelo de IA directamente en el ordenador o dispositivo del usuario, en lugar de enviar las solicitudes a servidores remotos. Para Altman, esta práctica desaprovecha memoria DRAM que, según él, rendiría mucho más si se concentrara en centros de datos de alto uso continuo.
El precio de la DRAM y la escasez que preocupa a la industria
El trasfondo de esta discusión tiene nombre y cifras concretas. La memoria DRAM, que hace apenas cinco años se vendía a precios bajos, se ha convertido en un recurso crítico para toda la cadena de producción de inteligencia artificial.
De acuerdo con datos de TrendForce, los precios de este componente aumentaron entre un 90% y un 95% durante el primer trimestre de 2026, y las proyecciones no anticipan una caída a corto plazo.
Ese encarecimiento no es un fenómeno aislado, sino el resultado de una demanda que crece más rápido que la capacidad de producción. Empresas como Micron y SK Hynix, que concentran el control global de la fabricación de DRAM, no logran escalar su producción al ritmo que exigen los hiperescaladores, es decir, las compañías que operan los grandes centros de datos destinados a entrenar e inferir modelos de IA.
Esa brecha entre oferta y demanda es, según Altman, lo que justifica su postura sobre la inferencia local. Si toda la capacidad disponible de DRAM debería destinarse a maximizar el rendimiento en la nube, cualquier uso disperso en equipos domésticos representa, desde su óptica, una pérdida de eficiencia en un momento en que cada unidad de memoria cuenta.
La respuesta de los fabricantes ante la escasez de cómputo
El comentario de Altman sobre la DRAM surgió en un tramo de la conversación centrado en la escasez de cómputo que atraviesa la industria. El directivo sostiene que el mercado no está reaccionando con la rapidez necesaria y que los grandes fabricantes de memoria mantienen una inversión conservadora pese a los beneficios acumulados durante los últimos 12 meses.
Algunas compañías del sector han comenzado a moverse para habilitar nuevas plantas de producción. Parte de esa estrategia incluye limitar la fabricación de chips de consumo masivo para redirigir maquinaria hacia la memoria HBM, el tipo de memoria de alto rendimiento que requieren los centros de datos dedicados a IA.
Sin embargo, ese ajuste no es inmediato. Abrir nuevas plantas especializadas en memoria de alto rendimiento es un proceso que no se resuelve de un trimestre a otro, lo que explica por qué la tensión entre oferta y demanda persiste pese a los movimientos ya anunciados por los principales fabricantes.
La otra cara: privacidad y autonomía frente a la eficiencia global
Frente a la postura de Altman existe una visión distinta entre quienes optan por ejecutar modelos de inteligencia artificial en sus propios equipos. Para ese grupo de usuarios, los modelos de código abierto ya resuelven el problema que buscan solucionar sin necesidad de depender de infraestructura ajena.
A eso se suma un argumento que Altman no aborda directamente en su crítica: la privacidad. Ejecutar un modelo de forma local permite a los usuarios procesar información sensible sin que esta transite por servidores externos, algo que no se consigue utilizando servicios como ChatGPT.
Esa tensión entre eficiencia global y autonomía individual resume el fondo del debate planteado en Cheeky Pint. Mientras Altman defiende una concentración de recursos en la nube como respuesta a la escasez de DRAM, una parte de la comunidad tecnológica continúa apostando por el control directo de sus propios sistemas de IA, al margen de la lógica de optimización que plantea el CEO de OpenAI.